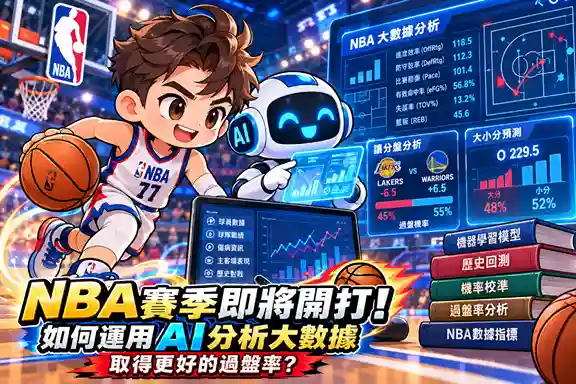
2026–27 NBA新賽季即將正式登場!根據NBA官方公布的賽程,
新賽季例行賽將於美國時間2026年10月20日開打。
隨著各隊陣容調整、球員交易、傷兵復出與季前熱身賽陸續展開,
NBA賽事分析也重新成為籃球迷關注的熱門話題。
過去分析NBA比賽,許多人習慣觀察球隊排名、
近期連勝紀錄、主客場表現與歷史對戰。
但隨著人工智慧(AI)、機器學習(Machine Learning)
與運動數據分析技術逐漸普及,
現在已經可以利用大量歷史比賽資料,
建立更完整的NBA賽事預測模型。
不過,AI真的能提高NBA過盤率嗎? 大數據能不能找出讓分盤與大小分的判斷依據? 又有哪些AI分析結果其實不值得相信?
這篇九象IX9將從NBA官方數據、AI預測模型、
讓分盤、大小分、機率計算與回測方法出發,
完整解析如何正確使用AI輔助NBA賽事分析,
以及AI預測的實際限制。
本文重點:
2026–27 NBA開季時間、AI籃球數據分析、
進攻與防守效率、Pace節奏、讓分盤過盤率、
大小分預測、AI模型回測及常見分析陷阱。
一、2026–27 NBA賽季什麼時候開打?為什麼開季前適合研究數據?
依照NBA官方公布的2026–27賽季重要日期,
季前賽於2026年10月3日開始,
例行賽則預定於美國時間10月20日正式開打。
對於關注NBA數據分析的球迷而言,
季前賽是觀察球隊陣容變化的重要時期,
但也必須注意:
季前賽數據不能直接當成例行賽的實力指標。
NBA開季前值得關注的五項變化
- 球員交易:明星球員轉隊可能改變球隊進攻體系與球權分配。
- 先發陣容:不同先發組合可能影響進攻效率與防守表現。
- 傷兵復出:主力球員回歸可能改變球隊原有的比賽節奏。
- 教練戰術:換帥或調整戰術可能影響三分出手比例及攻防速度。
- 新秀加入:年輕球員的上場時間與定位,可能影響輪替深度。
例如某支球隊上季以慢節奏、半場陣地戰為主,
但新賽季更換總教練並加入擅長快攻的球員,
那麼直接沿用上季的平均得分預測新賽季,
就可能出現明顯偏差。
因此,建立NBA AI分析模型時,
除了歷史數據,也應持續更新球隊名單、
球員上場時間、傷病資訊與近期戰術變化。
二、AI分析NBA需要哪些大數據?先認識六項重要指標
AI分析NBA並不是單純把球隊勝率輸入聊天機器人,
然後要求它回答哪一隊會贏。
真正的數據分析需要建立可查證的資料來源,
並將不同球隊的攻守表現轉換成可以比較的指標。
1. 進攻效率 OffRtg
Offensive Rating代表球隊每100回合所取得的得分。
例如某隊進攻效率為118,
代表其平均每100回合可以取得約118分。
相較單純觀察場均得分,進攻效率能在一定程度上排除比賽節奏差異,
更適合比較不同球隊的進攻表現。
2. 防守效率 DefRtg
Defensive Rating通常代表球隊每100回合的失分。
在相同計算口徑下,
數值越低通常代表防守端限制對手得分的能力越好。
3. 比賽節奏 Pace
Pace是NBA官方使用的重要進階數據,主要衡量球隊每48分鐘的回合數。
節奏越快,通常代表比賽擁有更多進攻回合;但回合增加不代表一定得高分,
仍需要搭配雙方進攻效率判斷。
4. 有效命中率 eFG%
eFG%會考慮三分球比兩分球多一分的價值,因此比傳統投籃命中率更適合比較球隊的投籃效率。
NBA官方計算公式:
eFG% =(投籃命中數 + 0.5 × 三分命中數)÷ 投籃出手數
5. 失誤率 TOV%
失誤率可以協助分析球隊在進攻過程中,有多少比例的回合因失誤而失去得分機會。
面對壓迫性防守較強的對手時,失誤率可能是重要的比賽觀察因素。
6. 籃板與二次進攻
進攻籃板可以延續原本的進攻回合,為球隊創造額外的出手機會。
因此在預估得分時,除了投籃命中率,也需要考慮籃板優勢與二次進攻效率。
| 數據指標 | 主要用途 | 分析方向 |
|---|---|---|
| OffRtg | 每100回合得分 | 進攻能力 |
| DefRtg | 每100回合失分 | 防守能力 |
| Pace | 每48分鐘回合數 | 比賽節奏 |
| eFG% | 調整三分價值的命中率 | 投籃效率 |
| TOV% | 失誤比例 | 球權損失 |
| 籃板數據 | 籃板控制與二次進攻 | 額外得分機會 |
上述指標都可以從NBA官方數據系統取得定義及相關統計資料。
AI模型的主要用途,就是將這些不同維度的資訊整合,
而不是只看其中一個數字決定比賽結果。
三、AI如何分析NBA讓分盤?過盤率與勝率其實不同
NBA投注分析最容易混淆的兩個概念,就是球隊勝率與讓分盤過盤率。
球隊贏球,不代表一定能通過讓分盤。
什麼是NBA讓分盤?
假設某場比賽的盤口為:
- A隊:-6.5
- B隊:+6.5
如果選擇A隊-6.5,代表A隊必須贏至少7分,才符合這個讓分盤條件。
即使A隊最終贏了5分,在-6.5的讓分條件下仍然沒有過盤。
AI如何估計讓分盤過盤率?
常見分析方法會先預估兩隊的得分差,再透過歷史分差的波動情況,
建立分差的機率分布。
例如以下純屬示範的模型輸出:
- AI預測A隊平均贏5分。
- 市場讓分盤為A隊-6.5。
- 模型估計A隊贏7分以上的機率為45%。
- 模型估計B隊+6.5過盤機率為55%。
這個結果表示模型認為A隊仍可能是較強的一方,但不一定能贏到市場要求的7分以上。
因此,AI分析讓分盤的重點不是只問:「哪一隊比較強?」
而是進一步分析:
「兩隊最終分差的機率分布, 與目前市場讓分條件有什麼差異?」
如果對讓分、大小分與賠率還不熟悉,可以先閱讀九象IX9的
體育盤口和賠率完整教學,
了解盤口正負號、賠率與結算方式。
四、AI可以預測NBA大小分嗎?利用Pace與攻守效率建立模型
除了讓分盤,NBA大小分也是適合進行統計建模的市場之一。
大小分主要判斷雙方在指定結算範圍內的總得分,是否高於或低於市場設定的分數。
AI預估總分的基本概念
一種簡化的建模方式,是先估計雙方平均進攻回合數,
再結合兩隊的進攻與防守效率,計算可能的總得分。
例如以下為教學假設:
- 預估比賽回合數:100
- A隊調整後預估進攻效率:115
- B隊調整後預估進攻效率:111
在每隊約100個回合的假設下:
A隊預估得分 = 100 × 115 ÷ 100 = 115分
B隊預估得分 = 100 × 111 ÷ 100 = 111分
預估總分 = 226分
如果市場大小分為229.5,模型的平均總分預估就比盤口低3.5分。
但這並不代表小分一定會過盤。
因為籃球總分受到三分命中率、罰球、
失誤、比賽末段犯規戰術、延長賽等因素影響,
實際總分可能與預測平均值出現很大差異。
真正完整的模型還需要估計總分分布
只預測226分仍然不夠。
AI還需要根據歷史比賽的誤差與波動,
估計總分超過229.5分的機率,
才能把平均得分預測轉換成大小分的機率評估。
分析重點:
Pace與攻守效率可以協助建立總分預測,
但「預估總分」不等於「大小分過盤率」。
要估計過盤率,還需要考慮比分分布與模型的不確定性。
五、NBA AI預測模型有哪些?ChatGPT、XGBoost與機器學習差在哪裡?
現在常見的AI工具與機器學習技術很多,但它們並不是同一種分析方式。
1. ChatGPT等生成式AI
生成式AI比較適合協助整理分析流程,例如解釋NBA數據、建立比較表、
協助撰寫Python分析程式,或將大量資料整理成可閱讀的研究報告。
不過,生成式AI如果沒有取得可靠的最新數據,就不應被視為即時賽事資料庫。
單純要求聊天機器人「預測今天NBA哪隊會過盤」,也不能證明回答具有經過回測的預測能力。
2. Logistic Regression邏輯斯迴歸
這是常見的統計分類模型,可以根據多項輸入變數,估計某個事件發生的機率。
例如輸入球隊近期攻守效率、主客場差異及休息天數,估計某隊贏球的機率。
3. Random Forest隨機森林
隨機森林結合多棵決策樹,可以分析不同數據特徵之間較複雜的關係。
例如某支球隊在特定休息天數、主客場與對手防守條件下,是否呈現不同的比賽表現。
4. XGBoost梯度提升模型
XGBoost是常見的表格資料機器學習方法,適合處理大量數值型與類別型特徵。
在NBA分析中,可以用來結合球隊效率、近期狀態、傷病變數及賽程資訊,
建立預測模型。
5. 神經網路與時間序列模型
神經網路可以處理更複雜的資料關係,部分研究也會結合球隊歷史表現、
投籃位置資料與時間序列資訊。
不過模型越複雜,不代表一定越準確。
如果訓練資料不足、特徵設計不佳或出現過度擬合,
複雜模型反而可能在新賽季表現不如簡單模型。
| 分析工具 | 主要用途 | 需要注意 |
|---|---|---|
| ChatGPT | 整理資料、輔助程式與解讀 | 須核實數據來源 |
| Logistic Regression | 機率預測基準模型 | 需檢查模型假設 |
| Random Forest | 分析非線性特徵 | 可能過度擬合 |
| XGBoost | 表格資料預測 | 需正確驗證及調參 |
| 神經網路 | 複雜特徵與時間序列 | 資料需求與維護成本較高 |
對一般NBA數據研究者而言,最重要的不是使用最昂貴的AI工具,
而是確保資料來源、訓練方式與測試結果都能被檢查。
六、AI預測NBA過盤率準不準?不能只看命中率
很多AI運動分析服務會宣稱:「AI預測命中率高達70%」、「大數據自動抓出高勝率盤口」,
甚至宣稱可以長期穩定獲利。
但在評估這些說法之前,首先要確認它所謂的命中率到底如何計算。
勝率、過盤率與投資報酬率是三個不同指標
- 勝率:預測球隊勝負正確的比例。
- 過盤率:預測指定讓分或大小分條件正確的比例。
- ROI:在指定賠率與投注成本下計算的實際報酬率。
例如一個模型在100場比賽中,有55場成功預測讓分盤,
過盤率就是55%。
但55%的過盤率是否能產生正報酬,還需要考慮實際賠率、
投注金額、走盤及其他結算規則。
以十進位賠率1.90為例
不考慮走盤與其他費用,其理論損益兩平機率為:
1 ÷ 1.90 = 約52.63%
也就是說,若每一筆投注都採用相同賠率1.90,
長期過盤率需要超過約52.63%,
才可能在這個簡化條件下產生正的數學期望值。
但真實市場的賠率不會每場都相同,
而且AI估計的過盤率也可能有誤差。
比預測正確率更重要的概念:機率校準
2024年一篇研究NBA機器學習投注模型的論文,
特別討論了Calibration(機率校準)的重要性。
所謂機率校準,
就是模型預測的機率是否符合長期實際發生頻率。
例如模型將100場比賽都評估為60%機率過盤,
理想情況下,
這一組事件的實際過盤比例應接近60%。
如果最後只有45場過盤,
就代表模型的機率估計可能過度樂觀。
因此評估NBA AI模型時,
不能只看它猜對多少場,
還需要檢查:
- 預測機率是否經過校準。
- 模型是否使用真正賽前可取得的資料。
- 是否存在資料洩漏或事後選擇樣本。
- 是否有完整紀錄失敗的預測。
- 是否能在不同賽季維持穩定表現。
- 是否將賠率與交易成本納入評估。
重要提醒:
AI模型即使在某一段歷史資料中達到較高過盤率,
也不能保證下一個NBA賽季會得到相同結果。
七、如何實測NBA AI分析?用歷史回測驗證模型,而不是只看推薦截圖
如果真的想知道AI分析NBA是否具有參考價值,
最重要的一步就是Backtesting(歷史回測)。
回測的目的,
是利用過去的比賽資料,
模擬模型在當時賽前能做出的預測,
再與實際結果比較。
第一步:建立歷史資料庫
資料至少應包含:
- 比賽日期
- 主隊與客隊
- 賽前球隊攻守效率
- 近期比賽表現
- 主客場與休息天數
- 已確認的傷病資訊
- 當時實際讓分盤與大小分
- 當時可取得的賠率
- 最終比分與盤口結果
第二步:依照時間順序分割資料
不能隨機把未來比賽的資訊混進過去的模型訓練中。
例如可以設計:
- 較早賽季:模型訓練資料
- 後續賽季:模型參數驗證
- 最新且未參與訓練的賽季:獨立測試資料
這種依時間順序驗證的方式,
比較接近真實賽前預測情境。
第三步:與簡單模型及市場基準比較
AI模型不應只跟隨機猜測比較,
還應與簡單統計模型及市場隱含機率比較。
如果複雜AI模型的預測品質,
沒有穩定優於簡單模型或市場基準,
就很難證明額外的複雜度具有實際價值。
第四步:同時記錄多項評估指標
| 評估項目 | 代表意義 |
|---|---|
| Accuracy | 分類預測正確比例 |
| ATS過盤率 | 讓分盤預測正確比例 |
| Brier Score | 機率預測誤差 |
| Log Loss | 機率預測品質 |
| Calibration | 預測機率與實際頻率是否一致 |
| ROI | 納入賠率後的歷史報酬 |
| Closing Line Value | 預測時的市場價格與收盤價格比較 |
第五步:進行賽前模擬追蹤
歷史回測完成後,還可以在新賽季進行不涉及真實投注的模擬紀錄。
例如每場比賽開始前固定記錄:
- 模型預測分差
- 模型預測總分
- 讓分盤過盤機率
- 大小分過盤機率
- 記錄時的市場盤口與賠率
- 最終實際結果
累積足夠樣本後,才能比較模型的賽前預測與實際結果。
這種方式比只挑出幾場成功預測的比賽,更能客觀判斷模型是否有用。
八、2026 NBA開季AI分析實戰流程:如何避免常見數據陷阱?
當NBA新賽季正式開打,可以建立一套固定的AI賽前分析流程。
步驟1:確認當日賽程與球隊名單
先從NBA官方賽程及可靠資料來源確認比賽,
避免使用錯誤對戰資訊或過期球員名單。
步驟2:整理近期攻守效率
比較兩隊的OffRtg、DefRtg、
Pace、eFG%與失誤率。
同時注意樣本數,
避免把少數幾場的極端表現當成長期實力。
步驟3:納入傷病與休息天數
主力球員缺席、背靠背賽程與客場移動,
都可能影響球隊的預期表現。
但這些因素的影響程度,應由歷史資料估計,
不能隨意指定固定加減分。
步驟4:建立分差與總分的預測分布
AI模型除了預測平均比分,還應估計結果的不確定性,
避免把單一預測分數誤認為確定結果。
步驟5:與市場盤口比較
例如模型預估某隊平均贏4分,市場卻開出-7.5,
可以進一步研究雙方評估差異來自哪裡。
但模型與市場不同,
不代表模型一定比較正確,
也可能是模型遺漏重要資訊。
步驟6:追蹤結果並持續修正
賽季進行期間,應定期檢查模型誤差、
不同盤口的表現與機率校準。
如果模型在新賽季持續出現偏差,
應檢查資料與模型設定,
而不是為了維持漂亮的歷史過盤率,
刻意刪除預測失敗的比賽。
使用AI分析NBA最常見的五大陷阱
- 資料過期:使用上季陣容預測已經換人的球隊。
- 樣本過少:只看最近3場就判斷球隊實力。
- 資料洩漏:不小心把賽後資訊放入賽前模型。
- 過度擬合:歷史回測很漂亮,新賽季卻失準。
- 只看命中率:忽略盤口、賠率、機率誤差及市場變化。
如果想進一步認識不同體育平台的盤口類型、
滾球與賠率功能,
可以延伸閱讀九象IX9:體育球版推薦與平台功能完整解析。
九象IX9觀點:
AI最大的價值是讓NBA賽事分析更有系統,
幫助使用者整理資料、量化假設與檢查預測誤差,
而不是提供一個保證過盤的神奇答案。
NBA AI大數據分析常見問題 FAQ
Q1:2026–27 NBA例行賽什麼時候開打?
依NBA官方公布的賽程,
2026–27 NBA例行賽預定於美國時間2026年10月20日開打。
台灣球迷觀看賽程時,
應留意美國與台灣之間的時差。
Q2:AI真的能提高NBA過盤率嗎?
AI可以協助整理數據、
建立預測模型與估計過盤機率,
但是否優於市場基準,
需要透過獨立樣本與長期回測驗證。
目前不能保證任何AI工具都能穩定提高過盤率。
Q3:NBA勝率高的球隊,讓分盤也比較容易過盤嗎?
不一定。
勝率衡量球隊贏球的比例,
讓分盤則取決於最終分差是否跨過指定門檻。
強隊即使經常獲勝,
也可能因市場讓分較深而無法過盤。
Q4:分析NBA大小分最重要的數據是什麼?
常見重要指標包括Pace、
進攻效率、防守效率、
有效命中率、失誤率與球員陣容。
完整模型還需要估計總分的機率分布。
Q5:可以直接使用ChatGPT預測NBA嗎?
ChatGPT可以協助整理分析方法、
解釋數據及撰寫模型程式,
但若沒有提供可靠且最新的資料,
不能把生成式回答視為已經驗證的即時預測結果。
Q6:NBA AI模型預測準確率60%,就代表有優勢嗎?
不一定。
首先要確認60%是勝負預測還是讓分盤預測,
並檢查樣本數、資料來源、
賠率、機率校準及獨立測試結果。
單一命中率不能證明長期具有優勢。
Q7:NBA季前賽數據可以用來預測例行賽嗎?
可以作為部分觀察資料,
但季前賽的上場時間、
輪替方式與比賽目標可能不同於例行賽。
因此不適合不經調整就直接套用。
Q8:如何知道NBA AI預測模型是不是過度擬合?
可以將資料依時間分成訓練、驗證及獨立測試區間,
比較模型在不同賽季的表現。
如果訓練資料表現很好,
但未見過的新賽季資料明顯失準,
就可能存在過度擬合。
Q9:AI分析NBA需要付費購買昂貴的軟體嗎?
不一定。
可以先從NBA官方統計資料、
試算表、Python及基礎統計模型開始。
重點是資料品質與驗證方法,
而不是工具價格。
結語:2026 NBA賽季即將開打,AI大數據能提升分析品質,但無法保證過盤
隨著2026–27 NBA新賽季即將展開,
人工智慧與大數據分析確實提供了更多研究籃球比賽的方法。
從OffRtg進攻效率、
DefRtg防守效率、Pace比賽節奏,
到機器學習模型、讓分盤機率、
大小分預測與歷史回測,
現在都可以透過數據工具建立較完整的分析流程。
不過,真正有價值的NBA AI分析,
並不是宣稱每場都能準確預測,
而是能夠清楚說明:
- 資料從哪裡來。
- 模型使用哪些賽前資訊。
- 預測結果如何計算。
- 過去測試是否具有代表性。
- 模型的誤差與不確定性有多大。
- 是否能在未見過的新賽季持續維持預測品質。
對喜歡研究NBA的球迷而言,
AI最適合扮演的是數據分析助手,
協助比較球隊實力、
辨識影響比賽的因素,
並讓預測過程更加透明。
但不論AI模型多麼複雜,
NBA比賽仍存在傷病、臨場戰術、
投籃波動與其他難以預測的因素,
因此沒有任何模型能保證長期過盤或穩定獲利。
九象IX9提醒:
AI分析與大數據模型僅供賽事研究及資訊參考,
歷史過盤率不代表未來結果,
任何預測都無法保證獲利。
請先了解體育盤口與結算規則,
並合理安排娛樂預算。